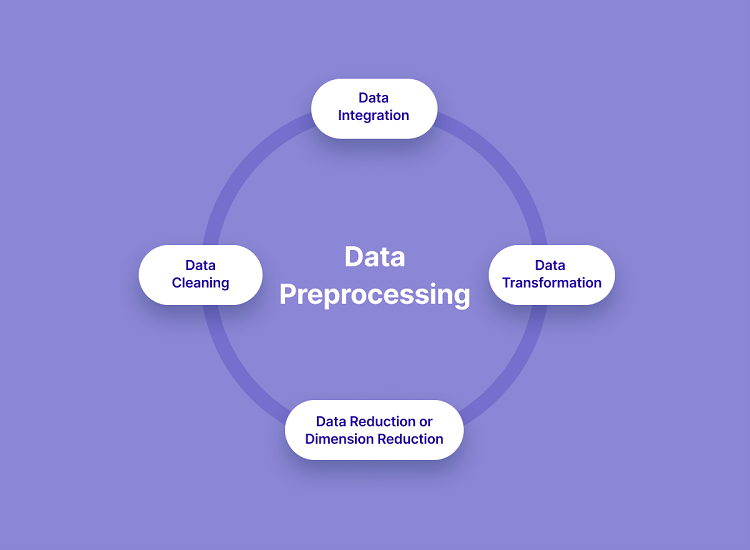
در شماره قبل (بخش نخست مقالات دادهکاوی بر مبنای چه فرآیندهایی انجام میشود؟ ) به این نکته اشاره کردیم که دادهکاوی بر مبنای یکسری فرآیندهای تکرار شونده انجام میشود. فرآیندهایی که ممکن است حالت چرخشی داشته باشند تا دادههای پالایش شدهای به دست آیند و خروجی دقیقتری به دست آید. در ادامه با مراحل فرمولهسازی مسئله و جمعآوری دادهها آشنا شدیم. در این مقاله با مراحل پیش پردازش داده ها، برآورد مدل، تفسیر مدل و نتیجهگیری آشنا میشویم.
پیش پردازش داده ها (Preprocessing the Data)
در حالت مشاهدهای (observational)، دادهها از طریق بانکهای اطلاعاتی، انبارههای داده و دادهگاههای (Data Mart) موجود جمعآوری میشوند. بهطور معمول، پیش پردازش داده ها شامل دو فرآیند زیر است:
شناسایی دادههای پِرت و حذف آنها (Outlier detection and remove): شناسایی دادههای پِرت میتواند در مرحله پیش پردازش داده ها یا به شکل یک فرآیند مستقل در دادهکاوی انجام شود. راهکارهای مختلفی برای شناسایی دادههای پِرت وجود دارد که معیار T2 و Q از جمله این روشها است.
دادههای پِرت که دادههای غیرقابل تشخیص نیز نامیده میشوند، دادههای غیر معمولی هستند که با اکثر مشاهدات عینی سازگار نیستند. عوامل مختلفی دادههای پِرت را پدید میآورند که از آن جمله میتوان به وجود خطا در اندازهگیری، کدنویسی اشتباه در چگونگی ضبط دادهها و مقادیر غیر عادی اشاره کرد.
این نمونهها به هیچ عنوان نماینده (Representative) قابل اعتمادی نیستند و میتوانند روی مدلی که قرار است ساخته شود، تأثیر منفی بگذارند. دو برنامه راهبردی زیر برای حل مشکل دادههای پِرت در دسترس متخصصان داده کاوی قرار دارد.
- شناسایی و سرانجام حذف دادههای پِرت به عنوان بخشی از مرحله پیش پردازش داده ها.
- طراحی روشهای مدلسازی قدرتمندی که نسبت با دادههای پِرت حساس هستند.
گسترشپذیری، کدگذاری و انتخاب ویژگیها (Scaling, encoding, and selecting features): پیش پردازش داده ها شامل مراحل چندگانهای نظیر مقیاسبندی متغیر و انواع مختلف کدگذاریها است.
بهطور مثال، یک ویژگی در محدوده [0,1] و ویژگی دیگری در محدوده [-100,1000] به لحاظ تکنیکی وزن یکسانی ندارند و علاوه بر این نتایج نهایی متفاوتی را در بحث دادهکاوی تولید میکنند. بنابراین توصیه میشود آنها را بسط دهید و برای هر دو ویژگی وزن یکسانی را در زمان تجزیه و تحلیل اختصاص دهید.
علاوه بر این، روشهای کدگذاری خاصمنظوره با ارائه تعداد کمتری ویژگی مفید و کاربردی سعی میکنند ابعاد دادههایی که قرار است در مدلسازی استفاده شوند را کاهش دهند. زمانی که تعداد ویژگیها زیاد میشود، به یکباره طبقهبندی دادهها با خطای زیادی همراه میشود، متخصصان برای حل این مشکل از رویکرد پیشگیری از مزاحمت ابعاد (Curse of Dimensionality) استفاده میکنند که اشاره به کاهش ابعاد دارد.
موارد یاد شده تنها بخش کوچکی از فعالیتهای پیشپردازشی هستند که در یک فرآیند دادهکاوی انجام میشود. البته به این نکته مهم دقت کنید که پیش پردازش داده ها نباید بهطور کامل مستقل از سایر مراحل دادهکاوی انجام شود. در هر تکرار فرآیند دادهکاوی، تمام فعالیتهای انجام شده ممکن است مجموعه دادههای بهبود یافته و جدیدی را برای تکرارهای بعدی تعریف کنند.
بهطور کلی، یک روش پیش پردازش داده های خوب بر مبنای دانش از قبل به دست آمده و تکنیکهای گسترشی و کدگذاری خاصمنظوره یک نمایش بهینه برای یک روش دادهکاوی ارائه میکنند. ما در آموزشهای آتی به تفصیل به سراغ تکنیکها و مرحله پیشپردازش خواهیم رفت و نشان میدهیم که چگونه فرآیند آمادهسازی و کاهش ابعاد دادهها را عملیاتی کنید.
دوره آموزشی برنامه نویسی پایتون ویژه نوجوانان(حضوری)
برآورد مدل (Estimate the model)
انتخاب و پیادهسازی تکنیک مناسبی برای انجام دادهکاوی فرآیند اصلی و مهم این مرحله است. این فرآیند ساده و سرراست نیست و بخش قابل توجهی از وقت متخصصان دادهکاوی را به خود اختصاص میدهد. این مرحله پیادهسازی بر مبنای چند مدل انجام میشود و برای انتخاب بهترین مدل باید کارهای مضاعف زیادی انجام شود.
ما در مقالههای آتی، اطلاعات بیشتری در خصوص اصول اولیه و چگونگی کشف دادهها ارائه میکنیم و در ادامه به تشریح و تجزیه و تحلیل تکنیکهای خاصی میپردازیم که اجازه میدهند یک فرآیند یادگیری موفق در ارتباط با استخراج دادهها و توسعه یک مدل مناسب را به کار ببرید.
تفسیر مدل و نتیجهگیری (Interpret the model and draw conclusions)
در بیشتر موارد، مدلهای دادهکاوی به این دلیل طراحی میشوند تا به کسبوکارها در اخذ تصمیمات راهبردی کمک کنند، بنابراین مدلها باید تفسیرپذیر باشند تا بتوان از آنها استفاده کرد. در بیشتر موارد، کاربران تمایلی ندارند تا تصمیمات خود را بر مبنای مدلهای پیچیدهای اتخاذ کنند که هیچگونه شناختی در مورد آنها ندارند و در اصطلاح تخصصی به آنها جعبه سیاه (Black-Box) گفته میشود.
نکته مهمی که به عنوان یک متخصص دادهکاوی باید به آن دقت کنید این است که گاهی اوقات تناقضی میان صحت تفسیر و صحت مدل وجود دارد. بهطور معمول، مدلهای ساده تفسیرپذیرتر هستند، اما دقت کمتری دارند. در حالت کلی، روشهای دادهکاوی مدرن به دلیل اینکه از مدلهای با ابعاد بالا (چندبعدی) استفاده میکنند، نتایج دقیقتری را ارائه میکنند.
مشکل تفسیر این مدلها که باید به آن دقت کنید این است که به تکنیکهای خاص و انجام کار جداگانهای برای اعتبارسنجی نتایج نیاز دارند. کاربران تمایلی ندارند صدها صفحه نتایجی را که به آمارها و ارقام مختلف اشاره دارند، مشاهده کنند. علاوه بر این، کاربران عادی قادر به درک نتایج نیستند و برای خلاصهسازی، تفسیر و بهکارگیری نتایج با هدف اخذ تصمیمات مهم دانش کافی را ندارند.
یک کارشناس دادهکاوی باید به این نکته مهم دقت کنید که دادهکاوی تنها در یک یا دو مرحله خاص خلاصه نمیشود. به عبارت دقیقتر، تنها زمانی یک مدل خوب و قدرتمند ساخته میشود که متخصص دادهکاوی شناخت دقیقی در ارتباط با فرآیندهای انجام شده در هر مرحله داشته باشد. شکل زیر چرخه انجام یک فرآیند دادهکاوی درست را نشان میدهد.
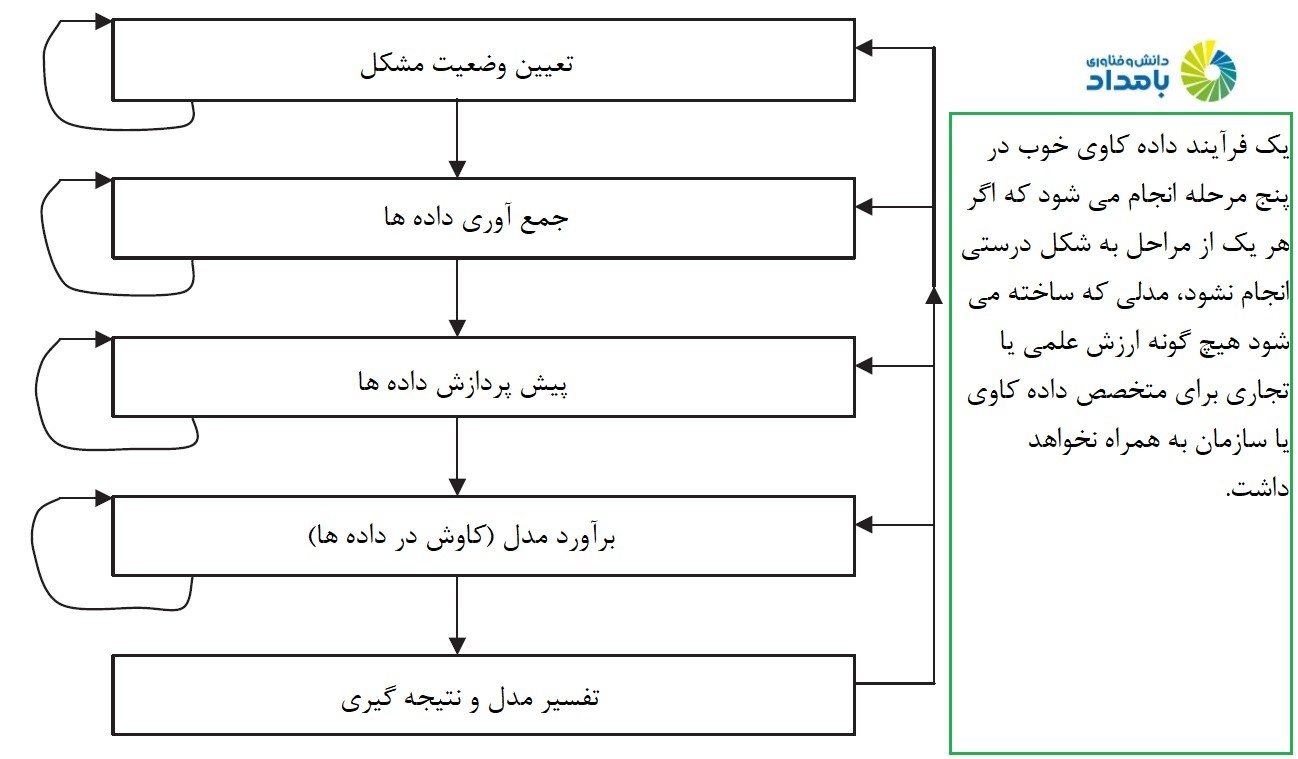
مهم نیست در چهارمین مرحله از چه راهکاری برای برآورد مدل استفاده میکنید، اگر در زمینه جمعآوری دادهها و پیش پردازش داده ها، عملکرد ضعیفی داشته باشید یا اگر فرمولهسازی مشکل را به شکل معناداری انجام نداده باشید، مدلی که ساخته میشود ارزشمند نیست.
یک ائتلاف جهانی
در سال 1991 چند شرکت بزرگ دنیای فناوری و اقتصاد نظیر شرکت خودروسازی بنز، ارائهدهنده خدمات بیمه OHRA، NCR Corp سازنده تجهیزات سختافزاری و نرمافزاری و SPSS Inc تولیدکننده نرمافزارهای آماری در یک همکاری مشترک اقدام به استانداردسازی رویکردها و فرآیندهای دادهکاوی کردند.
این همکاری مشترک باعث شد تا استانداردی بهنام فرآیند استاندارد صنعت متقابل برای دادهکاوی CRISP-DM سرنام Cross-Industry Standard Process for data mining ایجاد شود. شکل زیر فرآیندهای تشکیلدهنده دادهکاوی مبتنی بر استاندارد CRISP-DM را نشان میدهد.
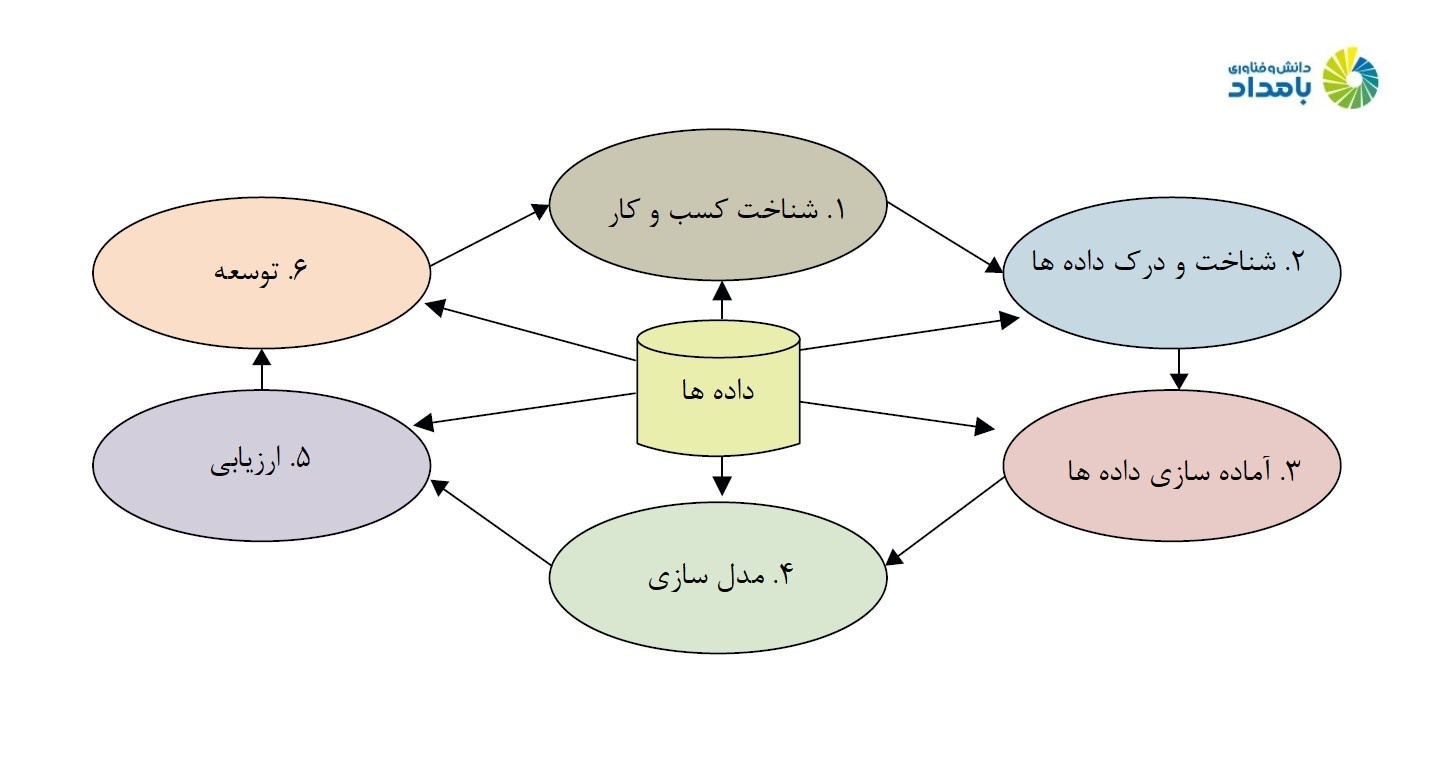
این استاندارد به گونهای تدوین شد که مستقل از هرگونه وابستگی به ابزار خاصی است. متدولوژی CRISP-DM موفق شد رویکرد ساخت یافته و نوینی در ارتباط با برنامهریزی پروژههای دادهکاوی ارائه کند. شش مرحله استاندارد CRISP-DM به شرح زیر است:
درک و شناخت کسبوکار: این مرحله بر شناخت اهداف و الزامات مدنظر کسبوکار و تبدیل این اطلاعات خام به دانشی که در زمینه دادهکاوی استفاده میشود، متمرکز است.
درک دادهها: این مرحله روی جمعآوری اولیه دادهها متمرکز است. در ادامه فرآیندهایی با هدف آشنا شدن با دادههاییی که قادر به تشریح مشکلات کیفی دادهها هستند انجام میشود. در این مرحله سعی میشود بینش اولیه از دادهها به دست آمده و در ادامه، مجموعه دادههای جالبی که برای شکل دادن به فرضیههایی که منجر به کشف اطلاعات مستتر میشوند، شناسایی شوند.
آمادهسازی دادهها: آمادهسازی دادهها شامل تمامی فعالیتهایی است که برای ایجاد مجموعه دادههای نهایی از مجموعه دادههای خام اولیه انجام میشود.
مدلسازی: در این مرحله روشهای مدلسازی انتخاب شده به شکل عملی روی مجموعه دادهها انجام میشود.
ارزیابی: زمانی که یک یا چند مدل ساخته شد که کیفیت بالایی دارند، یکبهیک ارزیابی میشوند تا مشخص شود مدلهای موجود برای دادههای رویت نشده قابلیت عمومیسازی دارند و به تمامی الزامات مهم پاسخ میدهند. در نهایت بهترین مدل انتخاب میشود.
توسعه: این مرحله شامل توسعه و استقرار مدلی است که قرار است از اطلاعات جدید برای حل مشکلات کسبوکار استفاده کند.
برنامههای کاربردی مختلف دادهکاوی، انعطافپذیری، قابلیت عملیاتی و مفید بودن خود را تنها زمانی نشان میدهند که در زمینه تجزیه و تحلیل مسائل پیچیده کسبوکار استفاده شوند. این مدل یک توالی ایدهآل از رخدادها را نشان میدهد. بر مبنای استاندارد فوق بسیاری از وظایف را میتوان به صورت متفاوتی انجام داد و اغلب لازم است به فعالیتهای انجام شده قبلی بازگشته و برخی اقدامات خاص را تکرار کرد.این مدل سعی نمیکند تمام مسیرهای احتمالی را از طریق فرآیند دادهکاوی ضبط کند. مدلسازی بر مبنای استاندارد فوق به خواننده یا مفسر اجازه میدهد با نگاه کردن به الگوهای ترسیم شده به شناسایی ارتباطات و شباهتهای میان مراحل دادهکاوی بپردازد.
مراحل کلیدی در پیش پردازش داده ها چیست؟
مراحل داده کاوی و پیش پردازش دادهها شامل مواردی میشود که در جدول زیر آنها را برای شما آوردهایم:
|
مراحل پیش پردازش داده |
توضیحات |
|
مدیریت مقادیر گم شده |
مقادیر گم شده یا از دست رفته، یک مشکل تکراری در پروژههای داده کاوی به شمار میآید. دلیل این موضوع نیز محدودیت دادههایی است که در دنیای واقعی وجود دارند. برای حل این مشکل، میتوانید راههای زیر را امتحان کنید: میتوانید این مقادیر را بدون تغییر رها کنید. میتوانید این مقادیر را با صفر جایگزین کنید. شما میتوانید از میانگین دادهها برای این اعداد از دست رفته استفاده کنید. میتوانید از روش درونیابی برای پرکردن این مقادیر استفاده کنید. با استفاده از برون یابی نیز میتوان این مقادیر را پر کرد. |
|
مقیاسبندی دادهها |
ستونهای مختلفی میتوانند در محدودههای متفاوت وجود داشته باشند. به همین علت، شما نیازمند این هستید که دادههای خود را وارد یک مقیاس مشخص کنید. برای واردکردن دادهها در یک مقیاس مشترک، میتوانید راهکارهای زیر را امتحان کنید:
روش مین مکس: مقادیر ویژگیها را بین هر محدوده انتخابی مانند 0 تا 5 قرار میدهد. مقیاسکننده استاندارد: این مقیاسکننده فرض میکند که متغیر به طور معمول توزیع شده است و سپس آن را به گونهای کاهش میدهد که انحراف استاندارد 1 و توزیع در مرکز 0 داشته باشد. مقیاسکننده قوی: ابتدا میانگین دادهها را محاسبه کرده و سپس دادهها را در محدوده اطراف میانگین پخش میکند. |
| حل نقاط پرت دادهها |
نقاط پرت در مجموعه دادهها، نقاطی هستند که با الگوی غالب مشاهده شده در دادهها مطابقت ندارند. آنها میتوانند اختلالاتی را در فرایند محاسبه دادههای شما ایجاد کنند. به همین علت، باید با روشهایی مانند شناسایی میانه و محدوده بین چارکی، اقدام به حذف نقاط پرت از دادههای خود کنید. |
|
رمزگذاری ویژگیها |
گاهی اوقات دادههای ما در قالبی هستند که توسط کامپیوتر قابل پردازش نیستند. در این شرایط، نیازمند این هستید که دادههای خود را بهصورت کد دربیاورید. برای این کار میتوانید از روشهای کلاسیک کدگذاری مانند Label/Ordinal Encoding، One hot encoding و کدگذاری باینری استفاده کنید. علاوه بر این، روشهای مدرنتری نیز برای انجام این کار وجود دارند که شامل روشهایی مانند Bayesian encoders میشوند. |
| کاهش بعد |
مدلهای یادگیری ماشین، به اندازه کافی برای مدیریت تعداد زیادی از ویژگیها مهارت ندارند. به همین علت، شما نیازمند این هستید که از تکنیکهای کاهش بعد، برای کم کردن ابعاد و ویژگیهای دادههای خود استفاده کنید. این کار باعث میشود تا زمان پردازش مدل کاهش پیدا کرده، به میزان زیادی دقت مدل افزایش پیدا کرده و در زمان برازش دادهها نیز صرفهجویی شود. |
تکنیک های پیش پردازش داده ها
تکنیکهای مهم پیش پردازش دادهها شامل موارد زیر میشود:
1- پاکسازی دادهها: یکی از مهمترین تکنیکهایی است که در پیش پردازش دادهها استفاده شده و میتواند مشاهده ناقص یا نادرست را شناسایی و آنها را رفع کند. این تکنیک میتواند به بهبود دادههای شما برای کارکردن با مدلهای یادگیری ماشین کمک کنند.
2- حذف دادههای نویز: دادههای نویز معمولا باعث میشوند تا محاسبات انجام شده روی دادهها به میزان زیادی تحت تاثیر قرار گرفته و دقت کافی نداشته باشد. تکنیک binning یک تکنیک رایج در این زمینه است که در آن ابتدا مقادیر را مرتب کرده و سپس آنها را به دستههای مختلف تقسیم میکنیم. در ادامه یک میانگین را در هر bin اعمال میکنید.
3- خطاهای ساختاری: این خطاها معمولا به اشتباهات تایپی و ناهماهنگی در دادهها اشاره دارند. تکنیکهای خودکاری که پایتون به شما ارائه میدهد، این امکان را برایتان فراهم میکند تا بتوانید خطاهای ساختاری را حل کرده و نیازی به مداخله دستی برای حل این مشکل نداشته باشید.
4- تکنیکهای انتخاب ویژگی: از جمله تکنیکهای محبوبی که در این زمینه استفاده میشوند، میتوان به همبستگی بین ویژگیها، تستهای آماری، حذف ویژگی بازگشتی و آستانه واریانس اشاره کرد.
5- تکنیکهای مهندسی داده: تکنیکهای استفاده شده در این زمینه شامل تجزیه و تحلیل DateTime، قالببندی مجدد کیفیتهای عددی و تجزیه صفات دستهبندی شده میشود که هریک ویژگیهای مخصوص به خود را دارند.
ابزارهای پیش پردازش داده
اگر قصد دارید از پایتون برای پیش پردازش داده ها استفاده کنید، میتوانید از کتابخانههای متن بازی که در این زمینه وجود دارند استفاده کرده و عملیات پیچیده را تنها با یک خط کد انجام دهید. برای مثال، برای انتساب هوشمند مقادیر گمشده در دادهها، تنها باید پکیج scikit learn’s impute library را نصب و از آن استفاده کنید. علاوه بر این، برای مقیاسبندی دادهها، میتوانید تابع MinMaxScaler را از پکیج پیش پردازش دادهها در پایتون فراخوانی کنید. دقت داشته باشید که در پکیجهای مختلف زبان پایتون، توابع بیشماری وجود دارند که فرایند پیشپردازش دادهها را برای شما راحتتر میکنند.
Autumunge یک ابزار عالی دیگر است که بهعنوان یک پلتفرم کتابخانه پایتون ساخته شده و دادههای جدولی را برای استفاده مستقیم از الگوریتمهای یادگیری ماشین آماده میکند.
زبان برنامهنویسی R ابزار دیگری است که میتوانید از پکیجهای این زبان نیز برای پیش پردازش دادههای خود استفاده کنید. دقت داشته باشید که این زبان، بیشتر با اهداف تحقیقاتی و آکادمیک مورداستفاده قرار میگیرد و در پروژههای دنیای واقعی، پایتون ابزار قدرتمندتری برای شما خواهد بود.
Weka یکی از نرمافزارهای محبوب در زمینه داده کاوی و پیش پردازش دادهها است که از طریق ابزارهای پیش پردازش داده داخلی و مدلهای یادگیری ماشین، میتواند در پیش پردازش دادهها به شما کمک کند.
RapidMiner نرمافزاری مشابه Weka است که یک نرمافزار کاملا متن باز بوده و دارای ابزارهای کارآمد زیادی برای پشتیبانی از پیش پردازش دادهها است.
برای کسب اطلاعات بیشتر در این زمینه با سایت آموزش برنامه نویسی بامداد همراه باشید.