همانگونه که در مقاله داده کاوی چیست، اشاره کردیم، فرایند داده کاوی، همانا شناسایی الگوها در مجموعه دادههای بزرگ است. دادهکاوی به دنبال آن است تا اطلاعات مستتر در حجم عظیمی از اطلاعات را با اتکا بر ابزارها و روشهای مختلف استخراج و به دانش قابل استفاده تبدیل کند. دانشی که بتواند به اشکال مختلفی همچون ادامه تولید یا توقف ساخت یک محصول یا ارائه یک سرویس کاربردی، به هوشمندسازی فرآیندهای مهم و تحلیل الگوهای رفتاری کاربران کمک کند.
پیش از شروع این نوشته، بهتر است بدانید که در بوت کمپ برنامه نویسی پایتون با یادگیری مهارت های مورد نیاز امکان آموزش داده کاوی با پایتون در قالب یک پروژه واقعی هم برای شما فراهم شده.
اگر شناخت قبلی در مورد سیستم هدف نداشته باشیم، شناسایی ساختار، کار دشواری میشود و مجبوریم ساختار را از طریق رویکردهای مبتنی بر آزمون و خطا انتخاب کنیم. اگرچه ما در مورد ساختارهای بیشتر سیستمهای مهندسی و فرآیندهای صنعتی دانش کافی داریم، اما در اکثر قریب به اتفاق سیستمهای هدف، که تمایل داریم از تکنیکهای دادهکاوی در مورد آنها استفاده کنیم، این ساختارها کاملاً ناشناخته هستند یا به اندازهای پیچیده هستند که دستیابی به ساختار آنها در جهت تعیین یک مدل ریاضی دقیق برای آنها غیرممکن است.
برای حل این مشکل، تکنیکهای جدیدی برای شناسایی پارامترها توسعه داده شده است که به عنوان طیفهای اصلی در تکنیکهای داده کاوی از آنها استفاده میشود. یادگیری همه این تکنیک ها با بوت کمپ برنامه نویسی برای شما آسان شده.
سرانجام، به این نکته مهم توجه داشته باشید که دادهکاوی میان دو اصطلاح “مدل” و “الگو” تمایز قائل شده است. مدل ساختاری “در مقیاس بزرگ” است، شاید بهطور خلاصه روابط مربوط به بسیاری از حالات یا گاهی اوقات همه حالات را نشان دهد، اما در نقطه مقابل، الگو ساختاری محلی است که موارد مختصری را نشان میدهد یا در یک محدوده کوچک از یک فضای داده وجود دارد.
در اینجا لازم است به نکته مهم دیگری نیز اشاره کنیم:
در اصطلاح تشخیص الگو (Pattern Recognition) واژه الگو (Pattern) معنا و تعریف مشخصی دارد، اما این واژه (Pattern) در دنیای دادهکاوی، معنای نسبتاً متفاوتی دارد. واژه مذکور در تشخیص الگو، به برداری از اندازهها برای مشخص کردن یک شیء خاص اشاره دارد که نقطهای در یک فضای داده چند بعدی است. در داده کاوی، الگو به یک مدل محلی ساده اشاره دارد.
در این دوره آموزشی، ما به بردارهای ان-بعدی از دادهها به عنوان نمونه اشاره میکنیم.
فرایند داده کاوی
به جای آنکه به سراغ بررسی همه رویکردهای ممکن و دیدگاههای مختلف در مورد داده کاوی برویم، اجازه دهید کار را با یک تعریف بدیهی ممکن که جنبههای مختلف دادهکاوی را نشان میدهد، آغاز کنیم:
فرایند داده کاوی، فرآیندی برای کشف مدلهای مختلف، خلاصهها و مقادیر مشتق شده از مجموعه دادهها است.
واژه “فرایند” در اینجا اهمیت زیادی دارد. حتی در برخی از محافل علمی این باور وجود دارد که دادهکاوی صرفاً شامل انتخاب و استفاده از یک ابزار مبتنی بر کامپیوتر برای شبیهسازی و تطبیق مشکل با یک مدل و پیدا کردن خودکار یک راهحل است. این دیدگاه اشتباهی است که بر مبنای نظریه ایدهآلسازی مصنوعی جهان ارائه شده است. دلایل مختلفی را میتوان برای اشتباه بودن این نظریه ارائه کرد.
یک دلیل مهم این است که دادهکاوی مجموعهای ساده متشکل از ابزارهای منفرد نیست که هر کدام عملکردی متفاوت از دیگری داشته باشند و تنها زمانی قابل استفاده باشند که قابلیت تطبیقپذیری با مشکلی را پیدا کنند.
دلیل دوم در مفهوم تطبیق یک مسئله با یک تکنیک نهفته است. به ندرت پیش میآید که یک پرسش یا مشکل تحقیقی به اندازه کافی دقیق شرح داده شده باشد که بتوان از یک روش کاربردی ساده که قابلیت تطبیق با مشکل را دارد، استفاده کرد.
در واقع، آنچه در عمل اتفاق میافتد این است که فرایند داده کاوی به یک فرآیند تکرارشونده تبدیل میشود. در این فرآیند، دادهها مطالعه و جمعآوری میشوند، دادهها با استفاده از برخی تکنیکهای تحلیلی بررسی میشوند، در مورد آنها تصمیمگیری میشود و از زاویه دیگری به دادهها نگاه شود و در نهایت ممکن است لازم باشد مفروضات بهدست آمده را ویرایش کرد.
پس از انجام این مراحل، دوباره به نقطه ابتدایی فرآیند باز میگردیم و ابزار تجزیه و تحلیل داده دیگری را مورد استفاده قرار میدهیم تا بتوانیم نتایج بهتری کسب کنیم. گاهی اوقات بهکارگیری یک ابزار جدید باعث میشود نتایج متفاوتی به دست آید.
این فرآیند تکرار میتواند به دفعات انجام شود و هر تکنیکی برای بررسی جنبههای کمی مختلف دادهها مورد استفاده قرار گیرد تا فقط دادههایی که برای تشریح سامانه و ساخت مدل مناسب هستند، باقی بمانند.
همانگونه که مشاهده میکنید دستیابی به دادهها شبیه به یک سفر اکتشافی است که هدفش استخراج هوشمندانه دادههای کاربردی است. به عنوان یک متخصص داده کاوی به این نکته مهم دقت کنید که دادهکاوی بهکارگیری تصادفی مباحث آماری، یادگیری ماشین یا سایر روشها و ابزارها نیست.
دادهکاوی به معنای بهکارگیری تصادفی تکنیکهای تحلیلی نیست، بلکه یک فرآیند دقیق و برنامهریزی شده در مورد بهکارگیری مفیدترین و سودبخشترین روشی است که در نهایت میتواند در اخذ تصمیمات استراتژیک به کار گرفته شود.
درک این نکته مهم است که کشف مشکل یا برآورد وابستگی دادهها یا کشف دادههای کاملاً جدید، تنها بخشی از رویه آزمایش عمومی است که توسط دانشمندان، مهندسان و سایر افرادی که مراحل استاندارد را برای نتیجهگیری از دادهها دنبال میکنند، مورد استفاده قرار میگیرد. رویه آزمایش عمومی سازگار با مسائل مرتبط با دادهکاوی شامل مراحل مختلفی میشود.
مراحلی که دادهکاوی بر مبنای آنها انجام میشود به شرح زیر است:
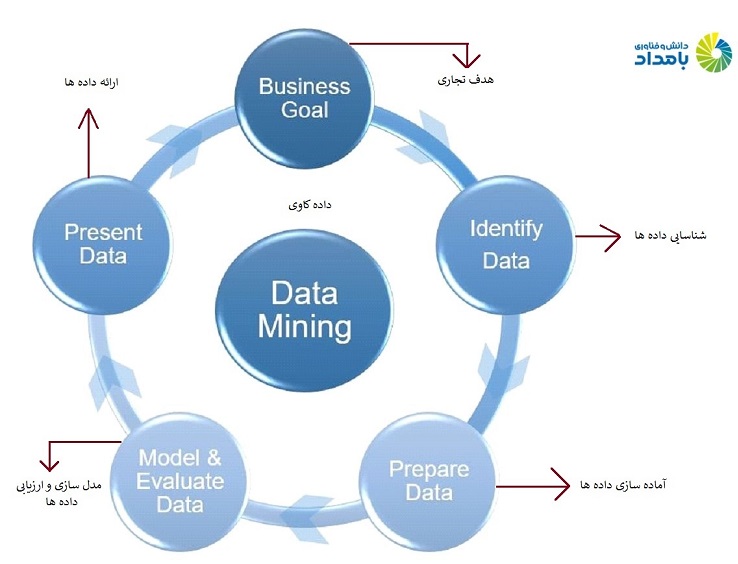
مرحله اول: وضعیت مسئله را مشخص کنید و فرضیه را فرموله کنید
بیشتر مطالعات مدلسازی مبتنی بر دادهها در یک حوزه کاربردی خاص انجام میشود. بنابراین، مهم است که در ارتباط با حوزهای که قرار است مشکل آن شناسایی و برطرف شود، دانش و تجربه لازم را داشته باشید تا بتوانید گزارهای معنادار ارائه دهید.
متأسفانه، تمرکز بسیاری از مطالعات کاربردی بر روش دادهکاوی مبتنی بر هزینهها (Expense) برای تشریح یک مسئله عینی استوار است. در این مرحله، مدلساز بهطور معمول مجموعهای از متغیرها را برای وابستگی ناشناخته و در صورت امکان، شکل کلی این وابستگی به عنوان یک فرضیه اولیه تعیین میکند.
در این مرحله ممکن است چندین فرضیه برای یک مسئله واحد تنظیم شوند. بر همین اساس، در اولین قدم به ترکیب دانش تخصصی در ارتباط با دامنه هدف و مدل دادهکاوی نیاز دارید. با توجه به اینکه متخصصان دادهکاوی در همه زمینهها اشراف کامل اطلاعاتی ندارند، در نتیجه باید تعامل نزدیکی میان کارشناس دادهکاوی و کارشناس متخصص آن حوزه وجود داشته باشد. در برنامههای موفق دادهکاوی این همکاری در مرحله اولیه به اتمام نمیرسد و تا پایان فرایند داده کاوی ادامه پیدا میکند.
مرحله دوم: دادهها را جمعآوری کنید
این مرحله در ارتباط با چگونگی تولید و جمعآوری دادهها است. بهطور کلی، دو احتمال متمایز وجود دارد.
اولین احتمال زمانی است که فرآیند تولید داده، تحت کنترل یک متخصص (مدلساز) است که به عنوان رویکرد آزمایش طراحی شده شناخته میشود.
دومین احتمال زمانی است که متخصص بر روند تولید دادهها تأثیرگذار نیست که رویکرد فوق به عنوان روش مشاهدهای شناخته میشود. رویکرد مشاهدهای همانگونه که از نامش پیدا است به فرآیند تولید دادههای تصادفی اشاره دارد که در بیشتر مباحث دادهکاوی ردپایی از آن مشاهده میشود.
یک توزیع نمونهبرداری/نمونهگیری (sampling distribution)، یک توزیع احتمالی آماری است که تعداد بیشتری نمونه از یک جمعیت خاص را جمعآوری میکند. توزیع جمعیت یکی از مباحث مهم آمار است که به توزیع تمام مشاهدات امکانپذیر اشاره دارد و در تعامل با توزیع فراوانی است که نوعی خلاصهسازی غنی از دادهها است.
توزیع فراوانی با طبقهبندی مشاهدات قادر است مشاهدات را بر حسب هر رده به شکل درصد یا مقداری توصیف کند. بهطور معمول، توزیع نمونهگیری پس از آنکه دادهها جمعآوری شدند کاملاً ناشناخته است یا بهطور جزئی و ضمنی در رویه جمعآوری دادهها مشاهده میشود.
پیشنهاد مقاله: پیش پردازش داده ها: دادهکاوی طی چه فرایندهایی انجام میشود؟
با این حال، درک چگونگی تأثیرگذاری مجموعه دادهها بر توزیع نظری بسیار مهم است، زیرا دانش پیشین میتواند برای مدلسازی و در آینده، برای تفسیر نهایی نتایج بسیار مفید باشد. علاوه بر این، مهم است که اطمینان حاصل کنید که دادههای مورد استفاده برای تخمین یک مدل و دادههایی که بعدا برای آزمایش و بهکارگیری یک مدل استفاده میشوند از همان توزیع نمونهبرداری باشند. اگر اینگونه نباشد، مدل تخمینی در ارائه نتایج نهایی با شکست روبرو خواهد شد.
برای افزایش دانش خود در زمینه های مربوط به آموزش برنامه نویسی با سایت بامداد همراه باشید.