یادگیری ماشین، همانطور که از نامش مشخص است،علم برنامهنویسی با هدف هوشمندسازی سامانههای کامپیوتری است، به طوری که کامپیوترها بتوانند از طریق دادههایی که در اختیار آنها قرار میگیرد، نکاتی را بیاموزند. آرتور ساموئل از متخصصان به نام این حوزه تعریف جالبی در ارتباط با یادگیری ماشین ارائه کرده که میگوید: «یادگیری ماشین رشتهای است که به رایانهها توانایی یادگیری بدون برنامهریزی صریح را میدهد». به طور معمول، الگوریتمهای یادگیری ماشین برای حل انواع مختلف مشکلات زندگی استفاده میشوند.
در گذشته، افراد با کدنویسی دستی همه الگوریتمها و فرمولهای ریاضی و آماری، وظایف یادگیری ماشین را انجام میدادند. همین مسئله باعث میشود، فرآیند انجام کارها زمانبر، خستهکننده و ناکارآمد باشد. اما در عصر جدید، کتابخانهها، فریمورکها و ماژولهای مختلف زبانهای برنامهنویسی مثل پایتون کارها را سادهتر و کارآمدتر کردهاند. امروزه در بوت کمپ پایتون متوجه میشویدکه پایتون یکی از محبوبترین زبانهای برنامهنویسی برای این کار است و توانسته است گوی سبقت را از رقبای خود بهروباید.
کتابخانه ی پایتون چیست؟
کتابخانه پایتون در واقع مجموعهای از کدهای از پیش نوشته شده است که کارهای روزمره در برنامهنویسی پایتون را برای شما راحتتر میکند. برای مثال، با استفاده از کتابخانه Seaborn، میتوانید تصویرسازیها را تنها با یک خط کد انجام دهید و نیازی نیست که تمامی کدها را از ابتدا خودتان بنویسید. برای اینکه بتوانید از یک شی در زبان پایتون نمودار ایجاد کنید، نیازمند این هستید که تعداد خطوط زیادی از کد را بنویسید تا این کار را برای شما انجام دهد. این در حالی است که با استفاده از کتابخانه Seaborn میتوانید با کمترین خطوط این کار را انجام دهید.
پشتیبانی توسط طیف بسیار گستردهای از کتابخانهها که هر یک قابلیت انجام یک وظیفه تخصصی را دارند زبان برنامهنویسی پایتون را بهعنوان بهترین زبان برنامهنویسی در حوزههای علم داده، یادگیری ماشین و هوش مصنوعی میشناسند. در بوت کمپ برنامه نویسی با دنیای گشترده این کتابخانه ها رو به رو می شوید. از کتابخانههای مهم پایتون که در یادگیری ماشین استفاده میشوند به موارد زیر باید اشاره کرد:
- Numpy
- Scipy
- Scikit-learn
- Theano
- TensorFlow
- Keras
- PyTorch
- Pandas
- Matplotlib
کتابخانه NumPy
NumPy یک کتابخانه پایتون بسیار محبوب برای پردازش آرایههای چند بعدی و ماتریسهای بزرگ است که با کمک مجموعه بز;رگی از توابع ریاضی سطح بالا به برنامهنویسان در انجام محاسبات کمک زیادی میکند. این کتابخانه در زمینه محاسبات علمی اساسی در یادگیری ماشین و به ویژه در ارتباط با جبر خطی، تبدیل فوریه و اعداد تصادفی کار برنامهنویسان را سادهتر کرده است. کتابخانههای پیشرفته مانند TensorFlow از NumPy به شکل داخلی برای دستکاری مولفههای داخلی خود که تنسورها (Tensor) نام دارد، استفاده میکنند. قطعه کد زیر نحوه استفاده از این کتابخانه را نشان میدهد.
# Python program using NumPy
# for some basic mathematical
# operations
import numpy as np
# Creating two arrays of rank 2
x = np.array([[1, 2], [3, 4]])
y = np.array([[5, 6], [7, 8]])
# Creating two arrays of rank 1
v = np.array([9, 10])
w = np.array([11, 12])
# Inner product of vectors
print(np.dot(v, w), "\n")
# Matrix and Vector product
print(np.dot(x, v), "\n")
# Matrix and matrix product
print(np.dot(x, y))
خروجی قطعه کد فوق به شرح زیر است:
219
[29 67]
[[19 22]
[43 50]]
کتابخانه SciPy
SciPy یک کتابخانه بسیار محبوب در بین علاقهمندان به یادگیری ماشین است، زیرا شامل ماژولهای مختلفی برای بهینهسازی، جبر خطی، ادغام و آمار ارائه میکند. لازم به توضیح است که تفاوتی میان کتابخانه SciPy و پشته SciPy تفاوت وجود دارد. SciPy یکی از بستههای اصلی است که پشته SciPy را تشکیل میدهد، علاوه بر این برای دستکاری تصویر نیز بسیار مفید است. قطعه کد زیر نحوه استفاده از این کتابخانه را نشان میدهد.
# Python script using Scipy
# for image manipulation
from scipy.misc import imread, imsave, imresize
# Read a JPEG image into a numpy array
img = imread('D:/Programs / cat.jpg') # path of the image
print(img.dtype, img.shape)
# Tinting the image
img_tint = img * [1, 0.45, 0.3]
# Saving the tinted image
imsave('D:/Programs / cat_tinted.jpg', img_tint)
# Resizing the tinted image to be 300 x 300 pixels
img_tint_resize = imresize(img_tint, (300, 300))
# Saving the resized tinted image
imsave('D:/Programs / cat_tinted_resized.jpg', img_tint_resize)
کتابخانه XGBoost
کتابخانه XGBoost در زبان برنامهنویسی پایتون یک کتابخانه قدرتمند است که بهعنوان تقویتکننده گرادیان توزیعشده و بهینهسازی این تقویتکننده استفاده میشود. این کتابخانه بسیار کارآمد و انعطافپذیر بوده و به شکلی طراحی شده که بتوانید از آن در انواع پروژههای پایتون استفاده کنید. این کتابخانه، الگوریتمهای یادگیری ماشین را تحت فریمورک Gradient Boosting پیادهسازی میکند. این کتابخانه یک تقویتکننده درختی موازی را ارائه میدهد که بسیاری از مشکلات علم داده را به روشی بسیار سریع و دقیق حل میکند.
از جمله ویژگیهای این کتابخانه یادگیری ماشین پایتون میتوان به موارد زیر اشاره کرد:
1- برای مدیریت مجموعه دادههای عظیم بهترین کتابخانه است.
2- فریمورکی را برای تقویت گرادیان در زبانهای مختلف مانند جاوا، سی پلاس پلاس، پایتون، جولیا و R ارائه میدهد.
3- از قابلیت یادگیری گروهی پشتیبانی میکند.
4- کتابخانهای کاملا مقیاسپذیر است که استراتژیهای مختلفی را برای موقعیتهای متفاوت ارائه میدهد.
5- با استفاده از آن میتوانید قدرت استراتژیهای خود را برای حل مسائل ارزیابی کنید.
6- میتوانید پارامترهای استراتژی خود را با استفاده از این کتابخانه بهبود دهید.
کتابخانه Scikit-learn
Scikit-learn یکی از محبوبترین کتابخانههای یادگیری ماشین در ارتباط با الگوریتمهای کلاسیک یادگیری ماشین است. کتابخانه مذکور بر مبنای دو کتابخانه اصلی پایتون، یعنی NumPy و SciPy ساخته شده است. Scikit-learn از اکثر الگوریتمهای یادگیری تحت نظارت و بدون نظارت پشتیبانی میکند. علاوه بر این، Scikit-learn میتواند برای داده کاوی و تجزیه و تحلیل دادهها استفاده شود که آن را به یک ابزار عالی برای شروع کار با یادگیری ماشین تبدیل میکند. قطعه کد زیر نحوه استفاده از کتابخانه فوق را نشان میدهد.
# Python script using Scikit-learn
# for Decision Tree Classifier
# Sample Decision Tree Classifier
from sklearn import datasets
from sklearn import metrics
from sklearn.tree import DecisionTreeClassifier
# load the iris datasets
dataset = datasets.load_iris()
# fit a CART model to the data
model = DecisionTreeClassifier()
model.fit(dataset.data, dataset.target)
print(model)
# make predictions
expected = dataset.target
predicted = model.predict(dataset.data)
# summarize the fit of the model
print(metrics.classification_report(expected, predicted))
print(metrics.confusion_matrix(expected, predicted))
خروجی قطعه کد فوق به شرح زیر است:
DecisionTreeClassifier(class_weight=None, criterion=’gini’, max_depth=None, max_features=None, max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, presort=False, random_state=None, splitter=’best’) precision recall f1-score support 0 1.00 1.00 1.00 50 1 1.00 1.00 1.00 50 2 1.00 1.00 1.00 50 micro avg 1.00 1.00 1.00 150 macro avg 1.00 1.00 1.00 150weighted avg 1.00 1.00 1.00 150 [[50 0 0] [ 0 50 0] [ 0 0 50]]
کتابخانه LightGBM
یکی دیگر از کتابخانههای پایتون برای یادگیری ماشین است که بهعنوان یک فریمورک تقویتکننده گرادیان از الگوریتمهای یادگیری که مبتنی بر درخت هستند، پشتیبانی میکند. این کتابخانه مزایای زیر را ارائه میدهد:
– سرعت و راندمان بالاتری نسبت به کتابخانههای مشابه دارد.
– نسبت به دیگر چارچوبها، مصرف حافظه کمتری داشته و البته دقت بالاتری را ارائه میدهد.
– از قابلیت یادگیری موازی و GPU نیز پشتیبانی میکند.
– توانایی مدیریت دادههای عظیم را داراست.
این کتابخانه توسط مایکروسافت طراحی شده و مبتنی بر الگوریتمی به همین نام است که الگوریتمی تقریبا جدید بوده و لیست طولانی از پارامترها را دریافت میکند. این کتابخانه، برای پروژههایی که اندازه دادهها در آن با سرعت زیادی رشد میکند، گزینهای ایدهآل خواهد بود. یکی از دلایل محبوبیت این کتابخانه این است که بر دقت نتایج تمرکز داشته و در نتیجه دانشمندان علم داده و متخصصان یادگیری ماشین، میتوانند از آن در پروژههایی که دقت برایشان اهمیت زیادی دارد، استفاده کنند
کتابخانه Theano
همه ما میدانیم که یادگیری ماشین اساساً مبتنی بر ریاضیات و آمار است. ثینو (Theano) یک کتابخانه محبوب پایتون است که برای تعریف، ارزیابی و بهینهسازی عبارات ریاضی که شامل آرایههای چند بعدی هستند مورد استفاده قرار میگیرد و جالب آنکه، فرآیند مذکور را به شیوه کارآمدی انجام میدهد. کتابخانه فوق با بهینهسازی نحوه استفاده از پردازنده مرکزی (CPU) و پردازنده گرافیکی (GPU) اجازه میدهد تا مدلهایی روان با عملکرد مطلوب طراحی شوند.
رویکردی که به طور گسترده برای آزمون واحد و تأیید، شناسایی و تشخیص انواع مختلف خطاها استفاده میشود. Theano یک کتابخانه بسیار قدرتمند است که قدمتی زیاد دارد و بیشتر در پروژههای علمی محاسباتی در مقیاس بزرگ مورد استفاده قرار میگیرد، اما به دلیل ترکیب نحوی سادهای و سهولت دسترسی توسعهدهندگان در پروژهها مورد استفاده قرار میگیرد. قطعه کد زیر نحوه استفاده از کتابخانه فوق را نشان میدهد.
# Python program using Theano
# for computing a Logistic
# Function
import theano
import theano.tensor as T
x = T.dmatrix('x')
s = 1 / (1 + T.exp(-x))
logistic = theano.function([x], s)
logistic([[0, 1], [-1, -2]])
خروجی قطعه کد فوق به شرح زیر است:
array([[0.5, 0.73105858], [0.26894142, 0.11920292]])
کتابخانه CatBoost
اگر به دنبال بهترین کتابخانه هوش مصنوعی پایتون هستید، کتابخانه CatBoost پایتون، میتواند گزینهای جذاب برای شما باشد. این کتابخانه بهصورت متن باز طراحی شده و کارایی بالایی را در تقویت گرادیان در درختهای تصمیم ارائه میدهد. این کتابخانه، مخصوص پروژههایی است که برای دستهبندی دادهها با چالش مواجه شدهاند. یکی از ویژگیهای مهم آن این است که امکان کارکردن با انواع دادهها را برای شما فراهم کرده و قابلیتهایی نظیر جستجو، ارائه سیستمهای توصیهدهنده، دستیار شخصی و … را به شما ارائه میدهد. از طرف دیگر، دقت نتایج حاصل از این کتابخانه نیز بسیار بالاست. از جمله ویژگیها و مزایای مهم کتابخانه CatBoost پایتون، میتوان به موارد زیر اشاره کرد:
1- این کتابخانه بدون نیاز به تنظیم پارامترهای خاصی، نتایجی عالی را در اختیار شما قرار میدهد.
2- از قابلیتهای دستهبندی پشتیبانی کرده و نتایج آموزشی خود را بهبود میدهد. پس شما نیازی به پیش پردازش دادهها نخواهید داشت که این موضوع میتواند در زمان شما صرفهجویی کند.
3- نسخه گرافیکی این کتابخانه بسیار سریع و مقیاسپذیر است و تنظیمات متعددی را نیز به شما ارائه میدهد.
4- در نسخه بهروزرسانی شده این کتابخانه، دقت آن به میزان زیادی افزایش پیدا کرده و نیاز به برازش اضافی را کاهش میدهد.
5- در نهایت باید بدانید که این کتابخانه، مدلی را آموزش داده که باعث افزایش سرعت و کارآمدی آن شده است.
کتابخانه TensorFlow
تنسورفلو (TensorFlow) یک کتابخانه منبع باز بسیار محبوب برای محاسبات عددی با کارایی بالا است که توسط تیم Google Brain گوگل توسعه یافته است. همانطور که از نام آن پیدا است، Tensorflow چارچوبی است که شامل تعریف و اجرای محاسبات شامل تانسورها است. ابزار فوق میتواند شبکههای عصبی عمیق را آموزش دهد و اجرا کند که در نتیجه قابلیت استفاده در ارتباط با توسعه برنامههای هوش مصنوعی پیشرفته را دارد. TensorFlow به طور گسترده در زمینه تحقیق و کاربرد یادگیری عمیق استفاده میشود. قطعه کد زیر نحوه استفاده از چارچوب فوق را نشان میدهد.
# Python program using TensorFlow
# for multiplying two arrays
# import `tensorflow`
import tensorflow as tf
# Initialize two constants
x1 = tf.constant([1, 2, 3, 4])
x2 = tf.constant([5, 6, 7, 8])
# Multiply
result = tf.multiply(x1, x2)
# Initialize the Session
sess = tf.Session()
# Print the result
print(sess.run(result))
# Close the session
sess.close()
خروجی قطعه کد فوق به شرح زیر است:
[ 5 12 21 32]
کتابخانه Eli5
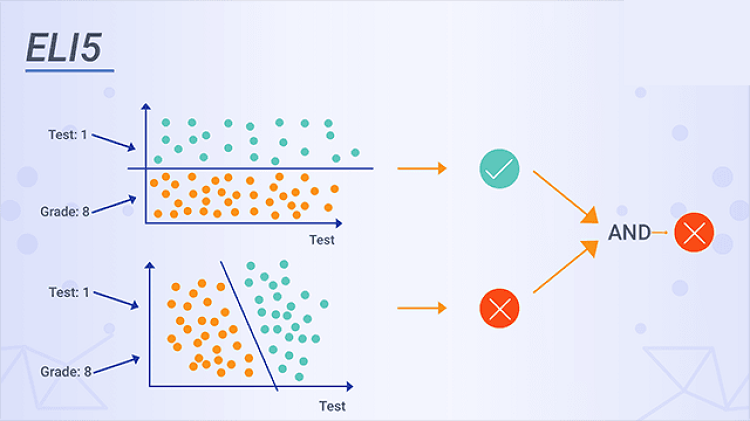
ELI5 یکی از پکیجهای زبان برنامهنویسی پایتون در حوزه یادگیری ماشین است که به اشکالزدایی و عیبیابی مدلهای طبقهبندی یادگیری ماشین کمک کرده و باعث پیشبینی دقیقتر آنها میشود. این کتابخانه، خود از پکیجهای یادگیری ماشین و فریمورکهای زیر استفاده میکند:
– scikit-learn
– درختهای تصمیم
– مدل SVG
– Keras
– XGBoost
– LightGBM
– CatBoost
این کتابخانه، ابزارهایی را برای کارکردن با دادههای غیرمتنی و طبقهبندیکنندههای دلخواه ارائه میدهد، ولی باید دقت داشته باشید که برخی از ویژگیهای آن در حال حاضر، در حالت آزمایشی قرار دارد. دادههای دریافتی از این کتابخانه را میتوانید در قالب جیسون دریافت کرده و با استفاده از ابزارهای جیسون، اقدام به تحلیل این نتایج کنید. شما میتوانید از این کتابخانه هم بهصورت یک مدل طبقهبندی و هم بهصورت یک مدل رگرسیون استفاده کرده و محدودیتی در این زمینه ندارید.
ویژگی مهم دیگر این کتابخانه این است که پارامترهای مدل آن کاملا قابل بررسی و تنظیم بوده و به شما کمک میکنند تا بتوانید درک درستی از کارکرد و ساختار این کتابخانه به دست بیاورید. در نهایت باید توجه کنید، این کتابخانه دارای الگوریتمهای متعددی است که در موقعیتهای مختلف، میتوانید از هر کدام آنها استفاده کنید.
کتابخانه Keras
Keras یک کتابخانه یادگیری ماشین بسیار محبوب برای پایتون است. کتابخانه مذکور یک واسط برنامهنویسی کاربردی برای شبکههای عصبی سطح بالا است که میتواند در بالای TensorFlow، CNTK یا Theano اجرا شود. کتابخانه فوق میتواند به طور یکپارچه بر روی هر دو مولفه پردازنده مرکزی و پردازنده گرافیکی اجرا شود. از اینرو، قادر به استفاده بهینه از هستههای پردازندههای فوق است. Keras گزینه مناسبی برای توسعهدهندگان تازهکار یادگیری ماشین است که قصد ساخت و طراحی یک شبکه عصبی را دارند. یکی از بهترین نکات در مورد Keras این است که امکان نمونهسازی آسان و سریع را فراهم میکند. کتابخانه مذکور با تمرکز بر قابلیت آزمایش سریع توسعه داده شده است. رسیدن از ایده به نتیجه با حداقل تاخیر ممکن کلید انجام پژوهشهای خوب است و این نکته در ساخت این کتابخانه همواره لحاظ شده.
کتابخانه PyTorch
PyTorch یک کتابخانه یادگیری ماشین منبع باز محبوب برای Python است که بر اساس Torch که در زبان برنامهنویسی سی پلاس پلاس طراحی شده مورد استفاده قرار میگیرد. بد نیست بدانید که پایتورچ یک کتابخانه یادگیری ماشین منبع باز است که با استفاده از زبان برنامهنویسی سی و بر مبنای الگوهای زبان برنامهنویسی Lua پیادهسازی شده است.
کتابخانه مذکور دارای طیف گستردهای از ابزارها و کتابخانهها است که همین مسئله باعث شده تا بتواند از بینایی کامپیوتر، پردازش زبان طبیعی (NLP) و بسیاری دیگر از برنامههای یادگیری ماشین پشتیبانی کند. کتابخانه فوق به توسعهدهندگان اجازه میدهد تا محاسباتی را روی Tensor با استفاده از پردازنده گرافیکی انجام دهند و همچنین به ایجاد نمودارهای محاسباتی کمک میکند. قطعه کد زیر نحوه استفاده از کتابخانه فوق را نشان میدهد.
# Python program using PyTorch
# for defining tensors fit a
# two-layer network to random
# data and calculating the loss
import torch
dtype = torch.float
device = torch.device("cpu")
# device = torch.device("cuda:0") Uncomment this to run on GPU
# N is batch size; D_in is input dimension;
# H is hidden dimension; D_out is output dimension.
N, D_in, H, D_out = 64, 1000, 100, 10
# Create random input and output data
x = torch.random(N, D_in, device = device, dtype = dtype)
y = torch.random(N, D_out, device = device, dtype = dtype)
# Randomly initialize weights
w1 = torch.random(D_in, H, device = device, dtype = dtype)
w2 = torch.random(H, D_out, device = device, dtype = dtype)
learning_rate = 1e-6
for t in range(500):
# Forward pass: compute predicted y
h = x.mm(w1)
h_relu = h.clamp(min = 0)
y_pred = h_relu.mm(w2)
# Compute and print loss
loss = (y_pred - y).pow(2).sum().item()
print(t, loss)
# Backprop to compute gradients of w1 and w2 with respect to loss
grad_y_pred = 2.0 * (y_pred - y)
grad_w2 = h_relu.t().mm(grad_y_pred)
grad_h_relu = grad_y_pred.mm(w2.t())
grad_h = grad_h_relu.clone()
grad_h[h < 0] = 0
grad_w1 = x.t().mm(grad_h)
# Update weights using gradient descent
w1 -= learning_rate * grad_w1
w2 -= learning_rate * grad_w2
خروجی قطعه کد فوق به شرح زیر است:
0 47168344.01 46385584.02 43153576.0………497 3.987660602433607e-05498 3.945609932998195e-05499 3.897604619851336e-05
کتابخانه Pandas
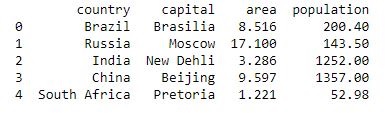
Pandas یک کتابخانه محبوب پایتون برای تجزیه و تحلیل دادهها است. البته به این نکته دقت کنید که پانداس ارتباط مستقیمی با یادگیری ماشین ندارد. همانطور که میدانیم مجموعه دادهها باید قبل از آموزش آماده شوند و معایب آنها برطرف شود. پاندا گزینه مفیدی در این زمینه است، زیرا به طور خاص برای استخراج و آمادهسازی دادهها توسعه یافته است. کتابخانه فوق ساختار دادههای سطح بالا و ابزارهای متنوعی را برای تجزیه و تحلیل دادهها در اختیار توسعهدهندگان قرار میدهد. علاوه بر این، توابع و راهحلهای کارآمدی در ارتباط با جستجو، ترکیب و فیلتر کردن دادهها فراهم میکند. قطعه کد زیر نحوه استفاده از کتابخانه فوق را نشان میدهد.
# Python program using Pandas for
# arranging a given set of data
# into a table
# importing pandas as pd
import pandas as pd
data = {"country": ["Brazil", "Russia", "India", "China", "South Africa"],
"capital": ["Brasilia", "Moscow", "New Delhi", "Beijing", "Pretoria"],
"area": [8.516, 17.10, 3.286, 9.597, 1.221],
"population": [200.4, 143.5, 1252, 1357, 52.98] }
data_table = pd.DataFrame(data)
print(data_table)
خروجی قطعه کد فوق به شرح زیر است:
مجتمع دانش و فناوری بامداد، ارائه میکند: بوتکمپ یادگیری عمیق، با رویکرد بینایی ماشین
کتابخانه Matplotlib
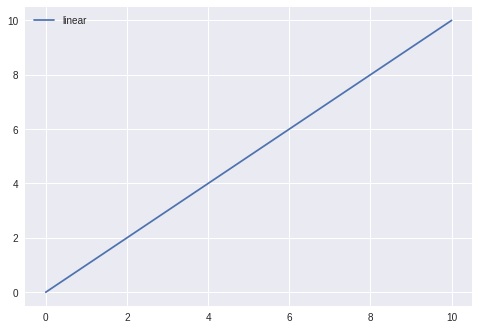
Matplotlib یک کتابخانه بسیار محبوب پایتون برای مصورسازی دادهها (نمایش گرافیکی دادهها) است. همانند کتابخانه پانداها، ارتباط مستقیمی با یادگیری ماشین ندارد. با این حال، زمانی که یک برنامه نویس بخواهد الگوهای موجود در دادهها را مصورسازی کند، مفید است. Matplotlib یک کتابخانه رسم دو بعدی است که برای ایجاد نمودارها و نمودارهای دو بعدی استفاده میشود. ماژولی به نام pyplot ترسیم را برای برنامهنویسان آسان میکند، زیرا ویژگیهایی را برای کنترل سبکهای خط، ویژگیهای فونت، محورهای قالببندی و غیره ارائه میدهد. انواع نمودارها و دیاگرامها را برای مصورسازی دادهها، به عنوان مثال، هیستوگرام، نمودارهای خطا، میلهای و غیره فراهم میکند. قطعه کد زیر نحوه استفاده از کتابخانه فوق را نشان میدهد.
# Python program using Matplotlib
# for forming a linear plot
# importing the necessary packages and modules
import matplotlib.pyplot as plt
import numpy as np
# Prepare the data
x = np.linspace(0, 10, 100)
# Plot the data
plt.plot(x, x, label ='linear')
# Add a legend
plt.legend()
# Show the plot
plt.show()
خروجی قطعه کد فوق به شرح زیر است:
کتابخانه PyBrain
PyBrain یک کتابخانه یادگیری ماشین برای پایتون است. هدف از این کتابخانه ارائه الگوریتمهای انعطافپذیر و با کاربری آسان اما در عین حال قدرتمند برای وظایف یادگیری ماشین و محیطهای از پیش تعریف شده برای تست و مقایسه الگوریتمها است.
StatsModels
StatsModels یک بسته (Package) پایتون است که نقش مکمل را برای کتابخانه scipy دارد که برای انجام محاسبات آماری شامل آمار توصیفی و تخمین و استنباط برای مدلهای آماری مورد استفاده قرار می گیرد.
کلام آخر
در یادگیری برنام نویسی لازم به توضیح است که کتابخانههای مذکور برای پروژههای مختلفی استفاده میشوند و قرار نیست در همه پروژهها از یک کتابخانه استفاده کنید. بهطور مثال، کتابخانه نرمافزاری متنباز تنسورفلو بیشتر در حوزه یادگیری ماشین کاربرد دارد، در حالی که کِرَس یک کتابخانه متنباز شبکه عصبی و قابل اجرا روی تنسورفلو یا ثینو است. دلیل این امر آن است که کِرَس مانند سایکیت لِرن بیشتر یک کتابخانه برای کاربر نهایی است، در حالیکه تنسورفلو بیشتر توسط افرادی مانند پژوهشگران و مهندسان یادگیری ماشین مورد استفاده قرار میگیرد.
علاوه بر این، به این نکته دقت کنید که کتابخانههای دیگری مثل LightGBM (یک چارچوب تقویت گرادیان با عملکرد بالا، توزیع شده و سریع (GBM ،GBRT ،GBDT یا MART) بر پایه الگوریتمهای درخت تصمیم است که برای رتبهبندی، دستهبندی و بسیاری دیگر از وظایف یادگیری ماشین طراحی شده) یا CatBoost یک روش یادگیری ماشین بر پایه تقویت گرادیان بر مبنای درختهای تصمیم است. از مزایای اصلی CatBoost میتوان به کیفیت فوقالعاده در مقایسه با دیگر کتابخانههای GBDT، سرعت عالی در استنباط دسته، پشتیبانی از ویژگیهای عددی و دستهای و وجود ابزارهای بصریسازی داده) اشاره کرد که در دسترس قرار دارند.
باید بدانید که برای یادگیری ماشین علاوه بر آشنایی با کتابخانه ها به بهترین زبان های برنامه نویسی یادگیری ماشین احتیاج دارید.